
TL;DR
Tenía un agente de IA self-hosted (Hermes Agent) corriendo en mi homelab, accesible solo por Telegram. Quería usarlo desde un navegador, fuera de casa, y poder elegir entre un modelo local gratis y Claude por API. Lo conseguí con un túnel WireGuard iniciado desde casa (cero puertos entrantes en el router), Open WebUI en un VPS detrás de Authelia con 2FA, y un perfil de agente donde Claude planifica y el modelo local escribe el código.
El camino tuvo siete tropiezos reales, y el cierre del proyecto cuatro más. Los más caros: un proveedor mal escrito que mandó todo a Claude de pago durante días sin avisar, y un rate limit que dejaba la interfaz en blanco. Los cuento con los números que medí, incluido uno que no conseguí arreglar, y con un par de veces en que mi primer diagnóstico estaba equivocado.
El problema / contexto
El montaje de partida:
- Un nodo «edge» pequeño en una DMZ (VLAN aislada) que ejecuta Hermes Agent, un agente open source con herramientas (terminal, ficheros, web) y un gateway de mensajería.
- Un servidor con GPU que sirve un modelo local (
qwen3.8:27b) con Ollama y es además el sandbox donde el agente ejecuta comandos. - Telegram como única interfaz.
Querer más no es capricho: desde el móvil Telegram va bien, pero para trabajo largo (revisar código, pegar logs, varias conversaciones en paralelo) un navegador es mejor. Y había una segunda necesidad de fondo, el flujo que más me interesa de los agentes:
Claude planifica, el modelo local programa.
Un modelo grande y caro decide qué hay que hacer y reparte tareas; uno pequeño y gratuito, en mi propia GPU, hace el volumen de tokens de código. Es el mismo patrón planificador/ejecutor de cualquier equipo humano.
Restricciones que me puse:
- Ningún puerto del homelab abierto a internet.
- El agente puede ejecutar comandos: lo que lo exponga tiene que tratarse como acceso remoto a una shell, no como «una web».
- Todo como código (IaC) y documentado, porque esto tiene que poder enseñarse como caso de estudio.
La arquitectura del agente de IA self-hosted
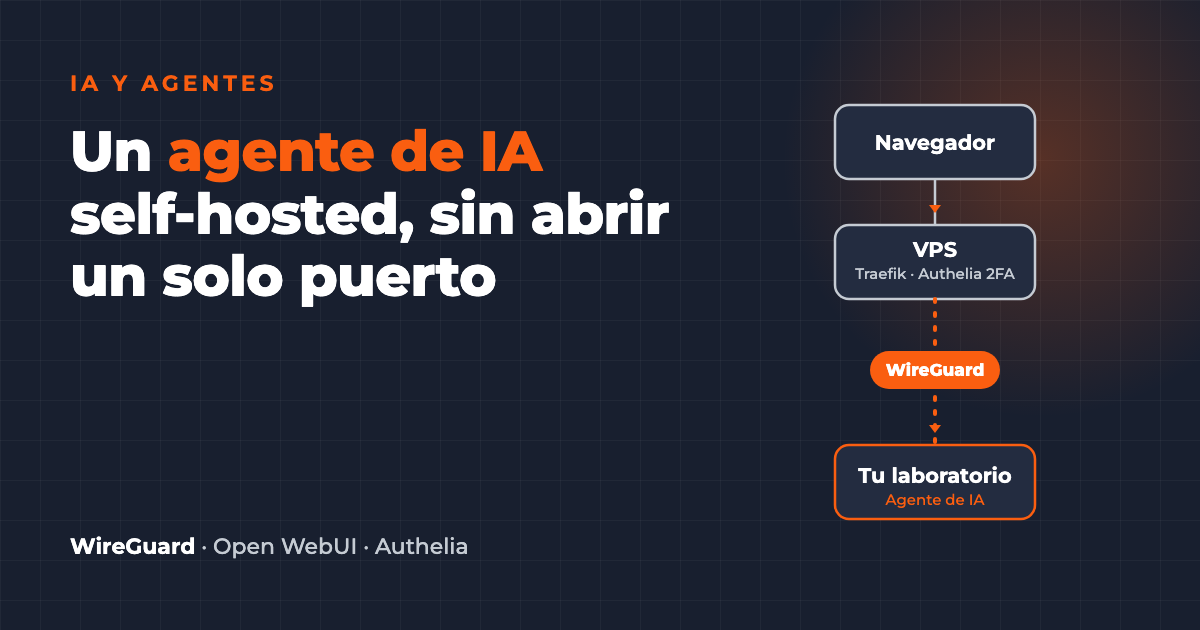
Diagrama del flujo: navegador → Traefik (VPS) → Authelia (SSO + 2FA) → Open WebUI → túnel WireGuard → firewall del lab → API del agente en el nodo edge → modelo local (Ollama) o, con el perfil planificador, API de Claude.
Navegador
  └─HTTPS─▶ Traefik (VPS)
             └─▶ Authelia (SSO + 2FA)
                  └─▶ Open WebUI
                       └─túnel WireGuard─▶ Firewall del lab (1 host, 1 puerto)
                                            └─▶ Nodo edge: API de Hermes
                                                 ├─Ollama─▶ Servidor GPU (Qwen 27B)
                                                 └─(perfil planificador)─▶ API de Claude
Las decisiones que sostienen todo:
1. El túnel lo inicia el lado de casa
El router doméstico está detrás de NAT y no quiero abrir nada. Así que el firewall del lab inicia la conexión WireGuard hacia el VPS (que tiene IP pública) con un PersistentKeepalive. El VPS solo escucha un puerto UDP, y WireGuard no responde a paquetes no autenticados, así que ese puerto no se deja descubrir ni escanear en la práctica.
2. Mínimo privilegio, de verdad
El VPS no ve «el lab»: ve un host y un puerto. La política es una sola regla en la interfaz de WireGuard (origen: el VPS; destino: el nodo edge; puerto: el de la API) y, además, un ufw en el propio nodo que solo acepta esa IP de origen. Dos capas independientes, porque este endpoint ejecuta un agente con terminal.
3. La API del agente exige clave y no escucha en todas partes
El API server de Hermes (compatible con OpenAI) se bindea a la IP de la DMZ, no a 0.0.0.0, y exige un bearer token de 64 hex. Sin clave, 401. Probé también que las dos claves (la del perfil por defecto y la del perfil Claude) no se intercambian: cada una solo abre su ruta.
4. Authelia delante, SSO por cabecera
Open WebUI va detrás de Traefik con el middleware de Authelia (two_factor, solo grupo admins). En vez de un segundo login, Open WebUI confía en la cabecera Remote-Email que Traefik añade tras validar la sesión. Eso solo es seguro si el contenedor no publica puertos y solo es alcanzable desde Traefik: lo dejé documentado en el propio docker-compose.yml.
5. Un solo listener, varios perfiles
Hermes tiene perfiles aislados. En modo multiplexado, un único listener sirve todos: el perfil por defecto en /v1 y el perfil claude en /p/claude/v1, cada uno con su clave. Resultado: cero puertos nuevos, cero reglas nuevas en el firewall para añadir el modelo Claude. En Open WebUI son dos conexiones y aparecen dos modelos en el desplegable.
Los 7 errores al exponer un agente de IA con WireGuard (la parte útil)
Error 1: el proveedor que no existía y el respaldo que pagaba en silencio
Días antes, alguien (yo, en otra sesión) cambió el modelo principal a provider: openai apuntando a Ollama. openai no es un proveedor válido en Hermes: para endpoints compatibles con OpenAI el nombre correcto es custom. Cada petición fallaba al resolver el principal y caía al fallback_model (Claude por OpenRouter, de pago). Todo funcionaba. Respondía bien. Y cobraba.
Lo descubrí al preguntarme por qué «todo iba por Claude» y leer el log:
Primary provider auth failed: Unknown provider 'openai'Lección: un fallback que funciona sin avisar es una factura esperando. Lo arreglé (custom) y añadí un hook de Hermes sobre post_api_request que avisa por Telegram cuando una llamada no va al modelo local. Lo probé apagando el servidor GPU: respondió con Claude y el hook registró el aviso; al volver, 0 avisos.
Error 2: el rate limit que rompió la interfaz
Tras desplegar, la pantalla se quedaba en blanco. En la consola del navegador:
TypeError: Importing a module script failedMi primera sospecha fue una CSP estricta. Descartada leyendo la definición del middleware (no define ninguna). Lo que sí mostraba el log de Traefik: 28 respuestas 429 a mi IP. Había puesto un rate-limit-strict (10 req/s) por reflejo, y la SPA de Open WebUI pide más de 200 módulos JavaScript de golpe; los rechazados hacen fallar el import() y la app no arranca. Lo bajé a un límite global… y siguió fallando: ni 100 req/s con ráfaga de 50 aguantaban esa carga. Al final quité el rate limit de ese router: el acceso ya lo cierra Authelia con 2FA y un límite por IP solo estorbaba.
Lección: antes de culpar al navegador, mide qué responde el proxy. Y un rate limit «por si acaso» delante de una SPA moderna es una trampa.
Error 3: OOM al arrancar (y la configuración que ignoraba el entorno)
El contenedor se reiniciaba en bucle: exit 137 y eventos oom. Open WebUI carga al arrancar un modelo local de embeddings (para RAG) con torch, y superaba el límite de 768 MB del contenedor, en un VPS con poca RAM libre. Subir el límite ponía en riesgo al resto de servicios, así que usé el motor de embeddings remoto (RAG_EMBEDDING_ENGINE=openai) para que no cargue nada local.
Y aquí la trampa: el cambio no hacía efecto. Las conexiones y ajustes de Open WebUI son configuración persistente: se leen del entorno solo en el primer arranque y luego manda la base de datos. Tuve que recrear el volumen (estaba vacío) y, para que no vuelva a pasar, fijar ENABLE_PERSISTENT_CONFIG=false: así el entorno, es decir, el código, es la fuente de verdad.
Lección: «configurable por variable de entorno» no siempre significa «el entorno manda». Lee si es persistente.
Error 4: despliegues en rojo con el servicio funcionando
Dos despliegues terminaron en failure aunque el contenedor nuevo estaba sano. Una carrera de Docker Compose recreando en caliente un contenedor de nombre fijo (marked for removal). Un docker compose down antes del up (conservando el volumen) lo resolvió. Y de paso aprendí que un cambio solo en el fichero del workflow no dispara el despliegue si los paths del trigger no lo incluyen: para validar el arreglo hubo que lanzarlo a mano.
Lección: un CI en rojo con producción en verde sigue siendo un problema: acostumbra a ignorar el rojo. Si quieres ver cómo monté ese pipeline desde cero, lo cuento en CI/CD profesional: del deploy manual a la automatización completa.
Error 5: Terraform sin backend remoto
Para abrir el puerto UDP del túnel en el firewall de la nube usé Terraform en CI. Descubrí que no había backend de estado: en cada ejecución el estado nacía vacío y un script reimportaba los recursos a mano. Dos consecuencias reales: un recurso fuera de esa lista falló con uniqueness_error, y el plan mostraba reglas del firewall «eliminadas y añadidas». Parecía grave. Leyendo el plan completo vi que eran las mismas once reglas reescritas en bloque (el proveedor las trata como lista) más la mía, con 0 destrucciones. Lo importante fue no aplicar sin leer el plan entero, y lanzar primero un plan desde la rama.
Cómo acabó: el estado vive ahora en un bucket S3 compatible (Hetzner Object Storage), con su ADR. El backend s3 no es AWS, así que hay que apagar las comprobaciones propias de AWS (skip_credentials_validation, skip_region_validation, skip_requesting_account_id, skip_metadata_api_check) y usar use_path_style. El bucket no lo crea Terraform (huevo y gallina) y, al no haber bloqueo nativo, serialicé el workflow con un concurrency group. Antes de fusionar, un plan desde la rama confirmó que el backend inicializa y que el resultado era «No changes»; ya en main, el primer apply dejó el estado (~110 KB) en el bucket.
Lección: lee el plan completo. Un apply automático sin estado persistente es una ruleta, y una migración de backend se verifica con un plan antes de fusionar.
Error 6: «ese usuario no existe»
El login de Authelia me decía que el usuario no existía. Existía: Authelia devuelve un mensaje genérico a propósito, y tras tres intentos fallidos banea unos minutos aunque luego aciertes. Los logs lo mostraban sin ambigüedad (Unsuccessful 1FA authentication attempt by user 'admin'). Moraleja de seguridad: el mensaje genérico es una feature, y el ban explica el «sigo sin poder entrar» de después.
Error 7: el que no conseguí arreglar (81 segundos)
Cuando el servidor GPU cae, el agente tarda ~81 s en saltar al respaldo. Probé la palanca documentada (api_max_retries: 1, «failover rápido»): no mejoró (86 s). Leyendo el código, el tope de conexión se deriva del timeout de lectura; acortarlo cortaría también generaciones largas legítimas de un modelo de 27B. Así que revertí el cambio y lo dejo documentado como límite conocido. Si el futuro necesita menos espera, la solución será externa (una comprobación de salud previa), no un timeout más corto.
Lección: no todo se arregla; saber cuándo un cambio no aporta y revertirlo es parte del trabajo.
Epílogo: cuatro lecciones al cerrar el proyecto
Con el acceso web funcionando, quedaban los flecos de infraestructura. Y ahí volvieron a morderme cosas, algunas por diagnosticar mal a la primera.
8. Quedarme fuera de mi propio servidor
Subí mi clave SSH a la consola del proveedor y seguía sin poder entrar. El servidor aceptaba la conexión y respondía Permission denied (publickey). La razón: las claves que subes a la consola solo se inyectan al crear el servidor; en uno ya existente no hacen nada. Además el sshd prohibía el login de root, así que ni siquiera añadiéndola a root habría entrado.
La solución fue el modo rescue: arrancar el servidor desde un sistema de recuperación, montar su disco, añadir la clave al usuario de despliegue (con copia de seguridad del fichero) y volver a arrancar. Un detalle que importa: hice un apagado ordenado (ACPI) antes de entrar en rescue, no un reset en seco, porque ese servidor lleva una base de datos de producción.
Lección: el panel del proveedor y el servidor son dos sitios distintos. Y entre un Shutdown y un Power cycle hay, a veces, una base de datos sin cerrar.
9. El 403 intermitente que no era culpa del SDK
Al migrar una aplicación de MinIO a Object Storage externo, las peticiones daban 403 a ratos. Mi primera hipótesis fue una incompatibilidad con los checksums que añaden los SDK modernos de AWS, y llegué a tocar la configuración del cliente. Estaba equivocado. Midiendo con reintentos, el mismo código daba 403 durante horas tras crear las credenciales y luego 0 fallos: la propagación de credenciales en el backend (Ceph) no es inmediata. Revertí el cambio.
De paso el código quedó más limpio: un único conjunto de variables S3_* (endpoint, puerto, SSL, región, bucket), sin credenciales por defecto y con el esquema HTTP/HTTPS derivado de una sola variable. Y como el docker compose up --remove-orphans retira solo los contenedores huérfanos, MinIO desapareció del despliegue sin intervención manual.
Lección: antes de culpar a una librería, mide el fallo con reintentos y a distintas horas. Una hipótesis que cambia código sin evidencia es ruido.
10. El CI en rojo cuya causa tenía dos capas
Un job de análisis de seguridad llevaba semanas en rojo en todas las PRs, con Resource not accessible by integration. Mi primer arreglo fue añadir el permiso actions: read, que era lo que decía el error. No bastó: al quitar ese error apareció el de verdad, Advanced Security must be enabled. Subir resultados a «code scanning» exige una licencia de pago en repos privados. La salida sin coste fue guardar el informe como artefacto del run en lugar de subirlo a la pestaña de seguridad.
Lección: un error de permisos puede ser solo la capa de arriba. Y un CI en rojo «de siempre» es deuda que esconde el rojo que sí importa.
11. Vulnerabilidades que no se pueden arreglar
La auditoría de dependencias fallaba por vulnerabilidades altas y críticas. Casi todas se resolvieron con overrides y subiendo versiones mayores de las herramientas de test. Una no tenía arreglo posible: la versión corregida que pedía el aviso no existe. Opté por ignorarla de forma explícita, con un comentario que explica por qué y cuándo retirar la excepción, en lugar de bajar el umbral de la auditoría para todos.
Lección: una excepción documentada y acotada es ingeniería; apagar la alarma, no.
Un apunte sobre trabajar con un agente
Durante esta sesión larga, el sistema de permisos de la herramienta bloqueó varias acciones aunque yo las había autorizado en el chat: reiniciar un servidor de producción, escribir una clave SSH en un servidor, fusionar una PR con un check en rojo. Lo viví primero como fricción. Después como lo que es: un control. En cada caso la acción acabó ejecutándola yo, a propósito, desde mi propia sesión. Con un agente con acceso a infraestructura, que las acciones irreversibles pasen por una decisión humana explícita no es un defecto.
Rendimiento y coste (números medidos)
- Herramientas: el agente exponía 23 herramientas (~11.100 tokens de definiciones). Desactivé, solo para la API web (Telegram mantiene todo), el navegador automatizado (con su bóveda de logins), la ejecución de código redundante y la visión: 15 herramientas, ~7.700 tokens. El prompt por petición bajó de 13.812 a 11.005 tokens (-20 %).
- Latencia: la primera petición tras cambiar el prompt tarda ~23 s (el modelo procesa todo en frío); las siguientes, ~3 s gracias a la caché de prompt.
- Coste de Claude: una tarea simple con delegación consumió ~31.000 tokens de entrada acumulados en el bucle de herramientas. Poco por tarea, pero conviene saberlo.
- Verificación independiente: para comprobar que «Claude planifica y Qwen programa» no me fié del relato del modelo: miré el log de Ollama (3 peticiones del nodo edge durante la tarea) y el fichero creado en el servidor GPU, ejecutándolo.
Seguridad de un agente de IA self-hosted: lo que no hay que olvidar
- Un agente con terminal es una shell remota. Toda la defensa en profundidad (túnel privado, una regla,
ufw, clave larga, 2FA) existe por eso. Y el proxy que lo expone también es superficie de ataque: antes de nada conviene leer Docker socket expuesto: una vulnerabilidad crítica y cómo cerrarla y Traefik y docker.sock: cómo reducir un riesgo crítico en 2 horas. - Búsqueda web = salida a un tercero. Las consultas del agente viajan al proveedor de búsqueda que uses. Para datos sensibles, un metabuscador autoalojado (SearXNG) es la alternativa; está en mi lista.
- Higiene de secretos: en una sesión larga con IA es fácil pegar una clave en el chat. Yo lo hice. Lo correcto es rotarlas, y dejar los secretos en ficheros locales con permisos
600que la herramienta lee sin imprimir.
Checklist para exponer tu agente de IA self-hosted sin puertos abiertos
- Túnel WireGuard iniciado desde el lab (
PersistentKeepalive), puerto UDP abierto solo en el extremo con IP pública. - Una regla de firewall en la interfaz del túnel: origen/destino/puerto concretos. Un
ufwen el destino con la misma restricción. - API del agente en la IP interna, con bearer token largo. Probar
401sin clave y con clave de otro perfil. - Reverse proxy con SSO/2FA delante. No publicar el puerto del contenedor si confías en cabeceras de identidad.
- Sin rate limit por IP delante de una SPA con cientos de módulos (o uno muy alto).
- Si la herramienta tiene config persistente: decide quién manda (entorno o base de datos) y fíjalo.
- Un aviso explícito cuando el sistema cae a un modelo de pago.
- Estado de Terraform remoto y
planleído entero antes de cadaapply. - Una clave en la consola del proveedor no entra en servidores ya creados: ten un plan de acceso (rescue) y haz apagado ordenado si hay base de datos.
Qué haría distinto
- Habría empezado con el hook de aviso de fallback: me habría ahorrado días de coste invisible.
- Habría medido la carga de módulos de la SPA antes de poner ningún límite.
- Habría puesto el estado de Terraform en remoto desde el primer día.
- Habría medido el 403 intermitente con reintentos antes de tocar una sola línea del cliente S3.
Próximos pasos para este agente de IA self-hosted: SearXNG privado como backend de búsqueda, una comprobación de salud que acorte el failover cuando el servidor GPU cae. Las credenciales que compartí durante las sesiones ya están rotadas.